

¿Qué es el texto a voz? Tecnología, herramientas y pruebas
¿Qué es el texto a voz? Una guía clara de cómo el TTS convierte texto y escaneos en audio, en qué se diferencia de un lector de pantalla y cómo probarlo.
Escucha las muestras de la prueba
Usa auriculares y mantén el mismo volumen si comparas muestras.
Ideas clave
- El texto a voz convierte caracteres escritos en audio hablado; los lectores de documentos añaden alrededor de ese motor la extracción, el OCR, la navegación, el almacenamiento y la reproducción.
- Un proceso típico normaliza el texto, predice la pronunciación y el fraseo, crea una representación de la voz y después sintetiza la onda sonora.
- Un lector de pantalla expone la estructura y los controles de la interfaz además del texto, mientras que un lector de TTS sencillo puede limitarse a narrar el contenido extraído.
- Prueba un sistema con tu propio texto difícil y comprueba nombres, cifras, OCR, tablas, privacidad y licencias, no solo una frase de demo bien pulida.
El texto a voz (TTS, por sus siglas en inglés, text-to-speech) es la tecnología que convierte el texto escrito en audio hablado. También se le llama síntesis de voz o conversión de texto a voz, y ya lo tienes: los ajustes de accesibilidad de tu móvil, Leer en voz alta de Edge y el modo Lectura de Chrome usan un motor de texto a voz, igual que las apps de lectura, los lectores de pantalla y los asistentes de voz.
Esos productos comparten la tecnología de voz, pero resuelven problemas muy distintos. Abajo seguimos una frase desde un documento hasta tus auriculares, explicamos qué hacen de verdad el OCR y las voces neuronales, aclaramos los términos que se suelen confundir y terminamos con una prueba rápida que te dirá más que una demo bien pulida.
La definición corta
El texto a voz (TTS) convierte caracteres escritos en audio hablado. El motor, en sentido estricto, recibe texto y produce voz. Una app para el público general puede hacer mucho más antes y después de ese paso:
archivo, página web o escaneo
        ↓
extracción u OCR
        ↓
texto limpio y estructura del documento
        ↓
normalización del texto y pronunciación
        ↓
modelo de voz y generación de audio
        ↓
reproductor, resaltado, navegación y exportación
Esta distinción importa al comparar productos. Una voz de gran calidad no puede arreglar un PDF a dos columnas mal extraído. Un OCR excelente no garantiza una buena pronunciación. Un reproductor pulido dice poco sobre la privacidad o sobre si puedes publicar el audio generado.
Cómo funciona el motor de voz
Las implementaciones varían, y los sistemas más nuevos pueden combinar varias etapas. Un modelo conceptual útil tiene cuatro partes.
1. Normalizar el texto
Los símbolos escritos necesitan una interpretación hablada. Fíjate en esta frase:
El Dr. Ruiz pagó $12.50 el 3/4/26 en la Av. Juárez n.º 5.
El sistema tiene que decidir cómo pronunciar Dr., Av. y n.º, si $ son pesos o dólares (en México, el signo $ se usa para el peso) y si 3/4/26 es el 3 de abril o, a la manera estadounidense, el 4 de marzo. La lectura correcta depende del idioma, la región y el contexto. También necesita reglas para direcciones web, abreviaturas, unidades, números de teléfono, emojis y signos de puntuación.
Los errores de normalización son una de las razones por las que una voz natural todavía puede decir algo mal. Con cifras o instrucciones que importan, sigue el texto con la vista y comprueba la fuente.
2. Predecir la pronunciación y el fraseo
El motor relaciona las palabras con sonidos del habla y decide los límites entre palabras, la acentuación y la entonación. En español la ortografía es bastante fiel a la pronunciación, pero no del todo: la x de «México» suena como una j y la de «taxi», no. En un texto en mayúsculas al que le faltan las tildes, «PAPA» puede ser «papa» o «papá». Los apellidos, los nombres extranjeros y las palabras en inglés metidas en una frase en español tampoco siguen las reglas habituales.
La prosodia es el patrón de ritmo, acentuación, duración y tono que ayuda a que el habla transmita estructura e intención. La puntuación da pistas, pero no una interpretación completa. Las frases largas, las citas, los títulos y las listas revelan si un sistema maneja bien el fraseo.
Algunos sistemas aceptan SSML, un lenguaje de marcado del W3C para controlar aspectos como la pronunciación, las pausas y el énfasis. El soporte varía. Un lector de documentos pensado para el público general puede no ofrecer SSML aunque el servicio que tiene debajo lo entienda.
3. Producir una representación acústica
Los antiguos sistemas concatenativos seleccionaban y unían fragmentos de voz grabada. El resultado podía ser inteligible, pero dejaba costuras audibles o un fraseo rígido. Los sistemas estadísticos predecían parámetros de la voz. Los sistemas neuronales modernos aprenden a partir de datos la relación entre texto y voz y pueden predecir una representación acústica más rica.
Que un sistema sea «neuronal» no garantiza precisión, naturalidad ni un entrenamiento responsable. La calidad sigue dependiendo de la voz, el idioma, el texto, el modelo, la compresión y los ajustes del producto. Pregunta a los proveedores por la cobertura de idiomas y por sus prácticas con los datos cuando esos factores te importen.
4. Generar la onda sonora
Un generador de forma de onda, que en un sistema neuronal por etapas suele llamarse vocoder, convierte la representación acústica en muestras de sonido. Algunas arquitecturas actuales generan la voz de forma más directa y no encajan en un esquema de manual tan limpio. El resultado práctico es el mismo: el producto tiene que crear audio que se pueda transmitir, guardar en caché o exportar.
La latencia, el coste de cómputo y la necesidad de conexión afectan a la experiencia. Un modelo grande en la nube puede sonar expresivo, pero necesita ir y volver por la red. Una voz más pequeña en el propio dispositivo puede empezar al instante y mantener en local el texto sensible. Ninguna es automáticamente mejor: decide el uso que le vayas a dar.
Dónde encajan el OCR y la extracción
El TTS no puede pronunciar letras que el sistema no ha recibido. Un PDF digital puede contener texto seleccionable. Un PDF escaneado o una foto de la cámara puede contener solo píxeles, así que primero necesita reconocimiento óptico de caracteres (OCR).
Prueba a seleccionar una frase. Si no se puede seleccionar ningún carácter, probablemente haga falta OCR. Pero que el texto se pueda seleccionar no demuestra que el documento esté limpio: las columnas, los encabezados, las notas al pie y las capas ocultas pueden salir en el orden equivocado.
Los errores de OCR importan porque el motor de voz pronuncia con total seguridad cualquier texto que recibe. Problemas habituales:
- leer dos columnas de lado a lado como si fueran una sola línea;
- confundir
0,O,1,leI; - perder tildes o eñes en papel gastado;
- meter encabezados o números de página en mitad de una frase;
- perder superíndices, ecuaciones y la relación entre las celdas de una tabla; y
- omitir pies de foto o notas al margen.
Para una novela que lees por placer, un error de vez en cuando puede ser tolerable. Para estudiar, para contratos, prospectos de medicamentos o información de seguridad, compara la salida del OCR con la imagen y recurre a una fuente profesional o accesible adecuada. Si vas a escanear páginas impresas, cómo convertir un libro físico en audio tiene una lista de comprobación para que salgan limpias.
Texto a voz, lectores de pantalla y generadores de voz no son sinónimos
Motor de texto a voz
El componente que pronuncia el texto. Los sistemas operativos, los navegadores, el software de accesibilidad y las apps pueden recurrir a uno.
Lector de documentos o de artículos
Un producto que importa contenido, extrae o escanea el texto, llama a un motor de TTS y añade una biblioteca, controles de velocidad y un reproductor. Las apps de Frateca para iOS, Android y web están en esta categoría: leen PDF (con OCR para los escaneados), artículos, ePub, archivos de Word y texto pegado en ocho idiomas, español incluido.
Extensión de lectura para el navegador
Un lector que funciona dentro del navegador, sobre la página que estás viendo, y que suele empezar a partir de un texto seleccionado. Como está en la propia página, puede resaltar las palabras ahí mismo en lugar de mostrar una copia reformateada. Algunas extensiones solo leen y olvidan. Otras, como la extensión de Frateca para Chrome, también guardan las páginas en una biblioteca que puedes volver a abrir en el móvil. En cualquier caso, una extensión necesita permiso para leer las páginas en las que la usas, así que comprueba qué envía y qué guarda; Chrome te muestra ese permiso al instalarla.
Lector de pantalla
Tecnología de apoyo como VoiceOver, TalkBack, NVDA o JAWS que expone el árbol de accesibilidad del sistema operativo o de la página web. Comunica funciones, nombres, estados, puntos de referencia y controles, y ofrece comandos de navegación. La voz es una salida; el braille puede ser otra.
Un narrador simplificado que lee el cuerpo del artículo puede ser cómodo, pero no sustituye el acceso estructural ni la interacción que da un lector de pantalla. Los recursos de accesibilidad del W3C que citamos en las fuentes explican el conjunto de herramientas.
Generador de voz con IA
Un término comercial amplio. Un producto puede convertir guiones en una locución de estudio; otro, traducir y doblar vídeos; otro, clonar a un locutor que lo ha autorizado; y otro, ofrecer simplemente TTS. «Voz con IA» describe la forma de generar la voz, no los permisos, la compatibilidad con documentos ni las funciones de accesibilidad.
Asistente de voz
Un sistema que reconoce peticiones habladas, realiza acciones y responde. Puede usar TTS para su respuesta, pero la síntesis de voz es solo una pieza del asistente.
Narración humana de audiolibros
Una interpretación hecha, grabada y editada por personas. El TTS ofrece inmediatez y libertad para elegir el texto; la narración humana ofrece una interpretación intencionada y una producción cuidada. Ninguna de las dos es mejor en todos los casos: depende del texto y de lo que busques.
Qué mejoraron las voces neuronales y qué no
Los modelos neuronales mejoraron la continuidad, el ritmo y la expresividad frente a muchas voces antiguas. Hicieron que la voz generada en textos largos resultara utilizable para mucha gente. No resolvieron todos los aspectos de la lectura.
Una voz moderna todavía puede:
- pronunciar mal el nombre de una persona;
- desarrollar mal una abreviatura;
- aplanar la ironía o los diálogos;
- leer una tabla como una lista sin sentido;
- sonar segura sobre un OCR defectuoso; o
- cansar a un oyente concreto a una velocidad concreta.
La naturalidad es subjetiva. La cobertura de idiomas puede parecer amplia en la página de un producto y quedarse corta para un acento regional concreto o para un documento que mezcla idiomas. En español, comprueba también si la voz suena peninsular o latinoamericana y si eso te importa. Prueba la combinación de texto y voz que vas a usar de verdad.
Los beneficios de accesibilidad exigen un producto accesible
El TTS puede ayudar a personas que no pueden leer cómodamente un texto visual, a personas con discapacidades que afectan a la lectura de texto impreso, a quienes aprenden idiomas y a cualquiera que tenga una barrera visual o física temporal. También puede reducir el tiempo frente a la pantalla o servir para revisar textos.
El motor de voz por sí solo no hace accesible una app. Importan el manejo con teclado, las etiquetas semánticas, el orden del foco, el resaltado ajustable, la elección de voz, las herramientas de pronunciación, la compatibilidad con braille y una estructura del documento fiable. Una persona puede preferir un lector de pantalla, texto y audio sincronizados, texto ampliado, braille o una combinación.
Evita las promesas médicas. El TTS no diagnostica ni trata la dislexia, el TDAH, el autismo, la baja visión ni las afecciones relacionadas con la edad. Es una herramienta cuya utilidad depende de la persona, del contenido y de las adaptaciones. Ante dificultades persistentes de lectura, visión o audición, busca orientación profesional cualificada.
Privacidad, consentimiento y derechos de uso
Las preguntas adecuadas dependen de lo que entra y de lo que sale.
Al escuchar documentos privados
Comprueba si el texto se sube a un servidor, si se conserva, si se usa para mejorar modelos, si se comparte con subencargados y si puedes borrarlo. Los documentos del trabajo, del centro de estudios o de clientes pueden exigir un servicio aprobado o un procesamiento en el propio dispositivo.
Al publicar voz generada
Los derechos para escuchar algo tú no incluyen automáticamente los derechos para una locución comercial. Revisa la licencia de salida del plan, los derechos del texto original y cualquier requisito de atribución.
Al clonar o imitar una voz
Consigue el permiso informado de la persona y ten en cuenta los riesgos de suplantación, fraude, empleo, privacidad y derechos de imagen. Que la tecnología pueda reproducir una voz no te autoriza a usarla. Los productos y las leyes de cada país son distintos, así que los usos importantes necesitan asesoramiento legal y normas de la plataforma actualizados.
Una prueba útil para comparar productos
No compares solo la demo pulida de cada proveedor. Usa la muestra y el método descritos en la ficha de la prueba y añade un documento real tuyo.
- Incluye un nombre, una abreviatura, una fecha, un decimal, una cantidad de dinero y una cita.
- Añade una frase larga en la que las pausas correctas cambien el sentido.
- Importa un escaneo a dos columnas para ver cómo ordena el OCR.
- Escucha a 1,0× y a la velocidad que usas normalmente.
- Compara dos voces sin cambiar el texto.
- Anota las pronunciaciones erróneas, las omisiones, el tiempo que tarda en empezar y las molestias al navegar.
- Revisa las condiciones actuales de privacidad, borrado, exportación y derechos de uso.
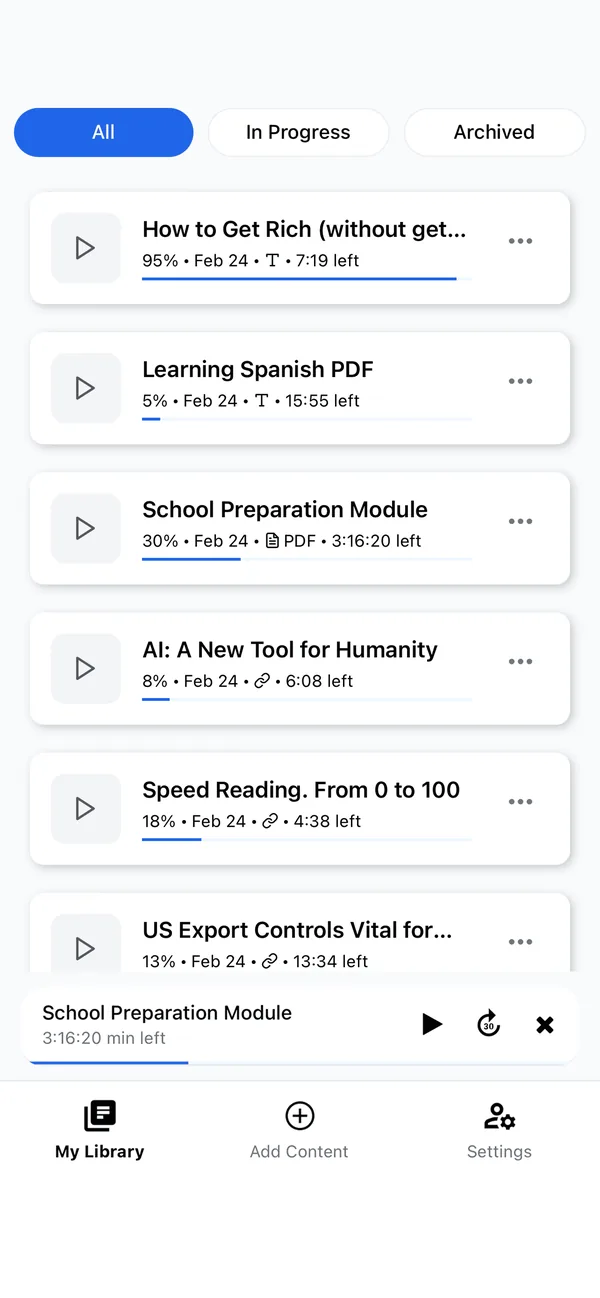
El audio insertado es una muestra en inglés publicada por Frateca, no una comparación independiente entre proveedores. La captura muestra la interfaz del lector que rodea al motor. Usa ambos para entender el producto y luego repite la prueba en otros con exactamente el mismo texto. Si vas a escuchar en español, haz la prueba con un párrafo en español: lo bien que suene una voz en inglés no dice cómo sonará en otro idioma.
Dónde ya tienes texto a voz
No necesitas instalar nada para probar el TTS:
| Dispositivo o navegador | Lector integrado |
|---|---|
| iPhone y iPad | Ajustes → Accesibilidad → Lectura y voz (Leer pantalla, Leer selección; «Contenido leído» en iOS 18 y anteriores), y en Safari, Leer en voz alta en el menú de la página («Escuchar lectura del contenido» en el español de Latinoamérica) |
| Android | Enunciar selección («Seleccionar para pronunciar» en el español de Latinoamérica), y en Chrome, ⋮ → Escuchar esta página |
| Microsoft Edge | Leer en voz alta (Ctrl + Mayús + U) |
| Chrome en el ordenador | Modo Lectura con un botón Reproducir |
En un iPhone configurado en español de Latinoamérica, la app de ajustes se llama Configuración. Estas herramientas sirven para una página cada vez. Las apps y extensiones de lectura añaden lo que rodea al motor: importar documentos enteros, OCR, una biblioteca y escuchar lejos de la pantalla. Si usas Android, la guía de apps de texto a voz para Android entra en detalle.
Elige el sistema según la tarea
Para una página web de vez en cuando, el navegador o el sistema operativo puede bastar. Para leer a menudo en la web con resaltado sobre la propia página, compara extensiones de texto a voz para Chrome. Para usar el ordenador de forma accesible, instala y configura un lector de pantalla de verdad. Para una cola de documentos, prioriza la extracción, el OCR, la navegación y la privacidad además de la calidad de la voz. Para producir locuciones públicas, investiga las licencias y el consentimiento.
El texto a voz es la capa de la voz, no toda la experiencia. Con esa distinción clara, es más fácil evaluar lo que promete cada producto. Puedes pegar hasta 3.000 caracteres de tu texto difícil en la demo en vivo, probar Frateca gratis con un documento completo o comparar alternativas en la mejor app de texto a voz gratis.
Deja de leer. Empieza a escuchar.
Frateca convierte PDF, artículos, libros de texto y páginas web en audio natural que puedes escuchar donde quieras: en el transporte, en el gimnasio o mientras cocinas. Plan gratis incluido, sin tarjeta.
 Añadir a Chrome
iOS · Android · Web · Extensión de Chrome · Plan gratis, sin tarjeta de crédito